
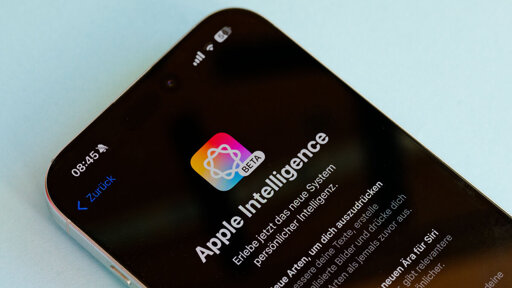
Apples Versprechen war simpel: Persönliche Daten von iPhone-Nutzern fließen niemals in das Training von KI-Modellen ein. Damit ist es jetzt vorbei.
Apples Versprechen war simpel: Persönliche Daten von iPhone-Nutzern fließen niemals in das Training von KI-Modellen ein. Damit ist es jetzt vorbei.
Naja, nein. Deine ursprüngliche Formulierung suggeriert das im ersten Moment angenommen wurde, das Apple Datenschutz ernst nimmt. Sonst würde die Neuigkeit das Feature nicht “in ein anderes Licht rücken”.
Lokal laufende Modelle und Modell Training mit Nutzerdaten sind 2 verschiedene paar Schuhe! Fast jedes moderne Handy kann zumindest lokal embedding Modelle laufen lassen. Mit lokalen Modellen kann Datenschutz funktionieren, da für die Funktion dieser eben keine Nutzerdaten weitergegeben werden müssen. Modelle trainieren ist aber eine andere Hausnummer, vor allem wenn’s gut werden soll. Das dürfte technisch noch nicht möglich sein, oder sehr lange brauchen und das Gerät extrem beanspruchen. Selbst das Finetuning der Modelle Lokal zu lösen dürfte dann nur unbemerkt möglich sein wenn das Telefon/Laptop über Nacht lädt.
Für das Training ist’s aber quasi Pflicht Daten in großen Stil ab zu greifen und sie in Rechenzentren zu verarbeiten und spätestens ab dem Punkt weiß keiner mehr wie es um den Datenschutz steht.
Doch, das weiß man.
Die Rohdaten werden in großem Stil gesammelt und dauerhaft gespeichert.
Das gilt auch für personenbezogene Daten.
Theoretisch könnte man sie anonymisieren, aber sie sind dann weniger wert, da der Wert der Daten grundsätzlich gerade darin besteht, dass sie vieldimensional sind, und sie vielfältige Zusammenhänge abbilden.
Also muss man davon ausgehen, dass massenweise personenbezogene Daten, z.B. hoch aufgelöste Smartphone-Ortungsdaten, dauerhaft gesammelt und gespeichert werden.
Und ich glaube, exakt dies ist das, wo Apple ein Problem hat: Nicht, diese aggressiven Methoden technisch durchzuziehen oder LLMs zu implementieren. Spracherkennung können sie doch auch. Sondern die Datenabsaugerei (auch wenn das beim Anzeigengeschäft auch sowieso geschieht) passt einfach wie Faust auf Auge zur Marke und zum Image von Apple, und könnte ziemlich toxisch für deren Geschäft sein.
Es ging mir darum, dass Apple seine ursprünglich dstenschutzfreundlichen Aussagen (nicht, dass ich denen das unbedingt glaube) zum Thema KI beginnt zurückzurollen. Das betrifft jetzt nur das Training mit Kundendaten, aber wer weiß denn was als nächstes kommt. Am Ende sind ja auch die Inputs in der alltäglichen Nutzung wertvoll zum trainieren
Genau das wird dahinter stecken, die gesamten Nutzungsdaten. Denn das sind ja Kundendaten. Und je vielfältiger die Daten, desto besser wird das Model. Ergo werden sie früher oder später alles nutzen was sie können. Nicht das man solche Daten auch Datenschutzkonform verarbeiten könnte, ich bezweifle aber das dort der durchaus große Aufwand betrieben wird alle Daten zu anonymisieren. Schließlich sind genaue Benutzerdaten viel Geld wert